
Попробуем выиграть в лотерею? Часть 2: анализ и первый прогноз
В первой части мы собрали часть истории тиражей «5 из 36» с nloto: около 7 тысяч тиражей, у каждого — выпавшие числа, всё в MySQL. Данные есть. Теперь начинается самое интересное — попробовать найти в них смысл.
Сразу предупрежу: никакой магии в этой части не будет. Мы посчитаем частоты, найдём редкие числа и построим первую (заведомо наивную) стратегию. А заодно честно обсудим, почему «редкие числа» — это ещё не рецепт выигрыша.
Если вы хотите не просто читать, а получить рабочий инструмент под свою лотерею или разобрать собственную стратегию — контакты в конце статьи.
С чего начинается анализ
Любая стратегия в лотерее упирается в один вопрос: какие числа ставить. И первый рефлекс любого игрока — посмотреть, какие числа выпадали реже, а какие чаще. Логика простая: если число выпадает редко, значит, «скоро должно выпасть». Если часто — «оно в ударе».
Обе логики — заблуждение. Лотерея — это независимые испытания: у каждого шара нет памяти, и вероятность выпасть у него одинакова в каждом тираже, сколько бы раз он ни выпадал до этого. Но это не значит, что частоты бесполезны. Они нужны для другого: чтобы понять структуру данных, увидеть аномалии и построить отправную точку для экспериментов.
Начнём с простого: посчитаем, сколько раз каждое число от 1 до 36 выпадало за всю историю.
Считаем частоты
Подключаемся к той же базе, что наполняли в первой части. Забираем все тиражи с числами одним JOIN-запросом и группируем результат в PHP-массив: тираж → список чисел.
function getDraws(int $lotteryId): array
{
    $conn = db();

    $sql = "
        SELECT d.id AS draw_id, d.draw_number, dn.number
        FROM draws d
        JOIN draw_numbers dn ON dn.draw_id = d.id
        WHERE d.lottery_id = ?
        ORDER BY CAST(d.draw_number AS UNSIGNED) ASC, dn.number ASC
    ";

    $stmt = $conn->prepare($sql);
    $stmt->bind_param('i', $lotteryId);
    $stmt->execute();

    $result = $stmt->get_result();
    $draws = [];

    while ($row = $result->fetch_assoc()) {
        $id = (int)$row['draw_id'];

        if (!isset($draws[$id])) {
            $draws[$id] = [
                'draw_number' => (int)$row['draw_number'],
                'numbers' => [],
            ];
        }

        $draws[$id]['numbers'][] = (int)$row['number'];
    }

    $stmt->close();

    return array_values($draws);
}
Сортировка по CAST(draw_number AS UNSIGNED) тут принципиальна. Номер тиража хранится строкой, и без приведения к числу «1000» окажется раньше «999» в лексикографическом порядке — а значит, «последний тираж» в массиве будет не тем, что мы ожидаем.
Дальше — сам подсчёт частот. Функция простейшая: инициализируем счётчики для всех чисел диапазона и пробегаем по всем тиражам.
function frequency(array $draws, int $min, int $max): array
{
    $result = [];

    for ($n = $min; $n <= $max; $n++) {
        $result[$n] = 0;
    }

    foreach ($draws as $draw) {
        foreach ($draw['numbers'] as $n) {
            if ($n >= $min && $n <= $max) {
                $result[$n]++;
            }
        }
    }

    return $result;
}
На выходе — массив вида [1 => 3784, 2 => 3812, ...]: для каждого числа — сколько раз оно выпало за всю историю. Вроде бы тривиально, но эти цифры — фундамент для всего дальнейшего.
Ищем пул редких чисел
Теперь нужно выбрать числа для ставки. Возьмём самый простой критерий — «редкие». Отсортируем все числа по частоте возрастания и отрежем первые несколько. Получим пул кандидатов, из которого потом будем собирать комбинацию.
function leastFrequentPool(array $freq, int $poolSize): array
{
    $numbers = array_keys($freq);

    usort($numbers, function ($a, $b) use ($freq) {
        if ($freq[$a] !== $freq[$b]) {
            return $freq[$a] <=> $freq[$b];
        }
        return $a <=> $b;
    });

    return array_slice($numbers, 0, $poolSize);
}
Размер пула вынесен в константу CANDIDATE_POOL. В нашем случае — 6. Почему 6, а не 5? Потому что одно число из пула может совпасть с обязательным числом из последнего тиража (об этом ниже), и тогда пул усохнет до 4, а нам нужно 5. Небольшой запас — и комбинация всегда собирается.
При равной частоте сортируем по возрастанию номера числа. Это не принципиально для стратегии, но делает результат воспроизводимым: при одинаковом наборе данных прогноз будет тем же.
Собираем комбинацию
Теперь сам прогноз. Идея, которую я заложил в первую версию, такая:
— одно число берём обязательно из предыдущего тиража (гипотеза «повтор»: одно число из тиража в тираж повторяется чаще, чем случайно);
— остальные четыре — случайные из пула редких чисел, без пересечения с обязательным.
function buildForecast(array $pool, array $lastDrawNumbers, int $count): array
{
    $lastDrawNumbers = array_values(array_unique($lastDrawNumbers));
    sort($lastDrawNumbers, SORT_NUMERIC);

    if (!$lastDrawNumbers) {
        throw new RuntimeException('Последний тираж пуст');
    }

    // Обязательное число — случайное из предыдущего тиража
    $required = $lastDrawNumbers[array_rand($lastDrawNumbers)];

    $candidates = array_values(array_filter(
        $pool, fn($n) => $n !== $required
    ));

    $need = $count - 1;
    $result = [$required];

    // Если пула не хватает — добираем из диапазона
    if (count($candidates) < $need) {
        $already = array_merge($result, $candidates);
        for ($n = NUMBERS_MIN; $n <= NUMBERS_MAX; $n++) {
            if (count($candidates) >= $need) break;
            if (in_array($n, $already, true)) continue;
            $candidates[] = $n;
        }
    }

    // Случайные $need чисел из кандидатов
    $keys = (array)array_rand($candidates, $need);
    foreach ($keys as $k) {
        $result[] = $candidates[$k];
    }

    $result = array_values(array_unique($result));
    sort($result, SORT_NUMERIC);

    return $result;
}
Обратите внимание на несколько защитных механизмов. Первый — array_unique на входе: если по какой-то причине в последнем тираже окажутся дубликаты (такое бывает при кривой вёрстке), мы не сломаемся. Второй — блок «добираем из диапазона»: если пул внезапно окажется короче, чем нужно, мы всё равно соберём комбинацию нужной длины. Третий — array_rand на массиве кандидатов: результат каждый раз новый, и на одной и той же истории мы получим разные прогнозы. Это плохо для воспроизводимости и хорошо для тестирования стратегии: будем прогонять её много раз.
Что показывает вывод
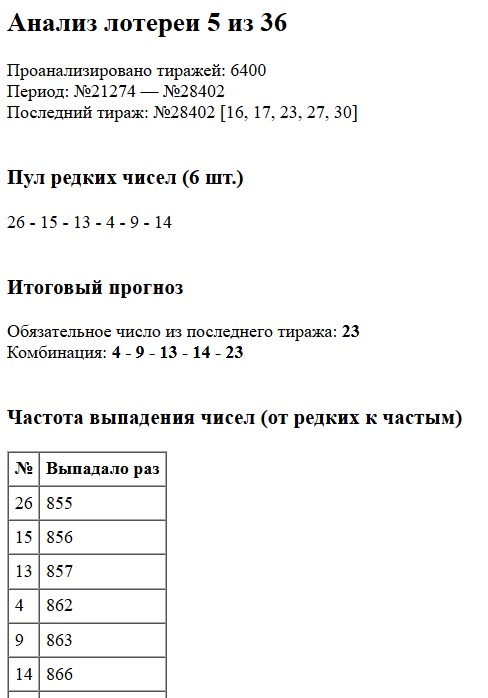
Собираем всё вместе и выводим отчёт. На экране — количество проанализированных тиражей, период, последний тираж, пул редких чисел, итоговая комбинация и таблица частот от редких к частым.
$totalDraws = count($draws);
$lastDraw   = $draws[$totalDraws - 1];

$freq     = frequency($draws, NUMBERS_MIN, NUMBERS_MAX);
$pool     = leastFrequentPool($freq, CANDIDATE_POOL);
$forecast = buildForecast($pool, $lastDraw['numbers'], NUMBERS_TO_PICK);

echo 'Проанализировано тиражей: ' . $totalDraws . '
';
echo 'Последний тираж: №' . $lastDraw['draw_number']
   . ' [' . implode(', ', $lastDraw['numbers']) . ']
';

echo 'Пул редких чисел: ' . implode(' - ', $pool) . '
';
echo 'Комбинация: ' . implode(' - ', $forecast) . '
';
По моим данным, разброс частот получился довольно узким: самые редкие и самые частые числа отличаются не в разы, а на проценты. Это ожидаемо: при 7 тысячах тиражей закон больших чисел выравнивает частоты почти идеально. И это первое честное наблюдение: «редких» чисел в сильном смысле этого слова в лотерее нет. Есть слегка менее частые — и всё.
Почему это не работает (и что с этим делать)
Стратегия «ставить редкие числа» — красивая, но математически бессмысленная в чистом виде. Каждое число выпадает с вероятностью 5/36 в каждом тираже, независимо от истории. Ставя редкое число, вы играете против случайности так же, как ставя частое.
Но! Есть один аспект, где статистика всё-таки имеет значение — выплаты. Если вы угадали 5 чисел, приз делится между всеми победителями. И вот тут играет роль, какие числа выбирают другие игроки. Многие ставят «красивые» комбинации: 1-2-3-4-5, дни рождения (1–31), числа из последнего тиража. Если ваша комбинация совпадёт с такой «популярной» — вы разделите приз с толпой. Если выберете что-то малопопулярное — заберёте больше.
То есть редкие числа работают не на вероятность выигрыша, а на размер выигрыша при условии, что вы уже выиграли. Это разные вещи, и путать их — классическая ошибка.
Есть и второй аспект — структура комбинации. Пять подряд идущих чисел, пять чисел из одного десятка, все чётные — такие комбинации выпадают с той же вероятностью, что и «случайные», но их выбирает меньше игроков. Это уже чистая теория игр: вы не увеличиваете шанс угадать, но уменьшаете ожидаемое число «счастливых конкурентов».
Что дальше
Это только первая итерация. В следующих частях мы:
— построим backtest: прогоним стратегию по всей истории и посмотрим, сколько было бы «троек», «четвёрок» и «пятёрок»;
— сравним её со случайной стратегией на тех же данных — и увидим, отличается ли результат вообще;
— добавим в прогноз структуру комбинации (сумма, чётность, распределение по диапазонам) — уже не ради «вероятности», а ради потенциальной выплаты;
— проверим гипотезу повтора числа из предыдущего тиража на реальной статистике — интересно, сколько в ней правды.
И самое главное — будем честны: пока что это гипотезы, а не доказанная стратегия. Но именно так и работает настоящий анализ данных: строим модель, проверяем на истории, отбрасываем то, что не работает, оставляем то, что даёт хоть какой-то сигнал.
Собирать данные — это половина дела. Проверять гипотезы — вторая половина. И самое интересное начинается именно сейчас.
—
Хотите прогнать свою стратегию по истории лотереи? Нужен парсер под другую лотерею, backtest или инструмент для анализа комбинаций? Пишите — обсудим задачу и найдём решение. Контакты — в профиле блога. Следующие части цикла выйдут совсем скоро, не пропустите.
Автор этого материала - я - Пахолков Юрий. Я оказываю услуги по написанию программ на языках Java, C++, C# (а также консультирую по ним) и созданию сайтов. Работаю с сайтами на CMS OpenCart, WordPress, ModX и самописными. Кроме этого, работаю напрямую с JavaScript, PHP, CSS, HTML - то есть могу доработать ваш сайт или помочь с веб-программированием. Пишите сюда.

 Программы на заказ
 Отзывы
 Контакты