
Попробуем выиграть в лотерею? Часть 1: сбор информации
Наверняка каждый хоть раз мечтал выиграть крупную или не очень сумму денег. Попробуем осуществить свою мечту? В этом цикле мы этим и займёмся. Всё в рамках закона.
Сайт — nloto, национальные лотереи. Начнём с лотереи «5 из 36». Правила просты — угадать 5 чисел в любом порядке. Угадал от трёх и выше — получаем приз.
Сразу оговорюсь: это не очередная статья из серии «выиграть в лотерею легко». Лотерея — это в первую очередь математика, статистика и дисциплина. Никакой мистики, никаких «счастливых чисел» и заговоров. Мы будем работать с данными, а уж что из них выйдет — увидим в следующих частях.
И да, сразу к делу: если вы хотите не просто читать, а получить работающий инструмент под себя — в конце статьи есть контакты. Можно заказать разработку парсера, консультацию по стратегии или что-то посерьёзнее. Пока же — с чего всё начинается.
С чего начинается любая стратегия
С данных.
Прежде чем строить прогнозы, считать вероятности и выдвигать гипотезы, нужно собрать историю. Все тиражи, все выпавшие числа, за как можно больший период. Без этого любые рассуждения — это гадание на кофейной гуще, а не анализ.
И тут начинаются первые сложности. Сайт nloto обычному скрипту на curl информацию не отдаёт — стоит защита, и страницы формируются JavaScript'ом. Значит, подключаем Selenium и управляем всем этим из Python.
Вторая сложность — если долбить сайт с постоянной частотой, можно быстро получить бан по IP или капчу. Поэтому добавляем случайные паузы в 1–3 секунды, работаем неспешно и аккуратно, имитируя поведение живого человека.
Что храним
Идея простая: в базе данных — таблицы тиражей и выпавших чисел. Плюс отдельная таблица для «битых» тиражей — тех, где страница не отдала данные (редирект, отсутствие чисел). Такие нельзя терять, но и в основную таблицу писать нечего — фиксируем их отдельно, чтобы не парсить по второму кругу.
Схема получается примерно такая:
CREATE TABLE draws (
    id          INT AUTO_INCREMENT PRIMARY KEY,
    lottery_id  INT NOT NULL,
    draw_number VARCHAR(32) NOT NULL,
    UNIQUE KEY uq_draws (lottery_id, draw_number)
);

CREATE TABLE draw_numbers (
    draw_id INT NOT NULL,
    number  INT NOT NULL,
    PRIMARY KEY (draw_id, number)
);

CREATE TABLE skipped_draws (
    lottery_id    INT NOT NULL,
    draw_number   VARCHAR(32) NOT NULL,
    reason        VARCHAR(64) NOT NULL,
    url_requested TEXT,
    url_final     TEXT,
    PRIMARY KEY (lottery_id, draw_number)
);
Ничего лишнего. draw_number специально храним строкой — у разных лотерей бывают свои особенности нумерации, а к числу приводим уже в запросах.
Драйвер, который не палится
Обычный Selenium сегодня детектируется почти везде. Поэтому используем библиотеку undetected-chromedriver — она патчит ChromeDriver так, что браузер перестаёт выглядеть как «управляемый роботом».
import undetected_chromedriver as uc

def get_driver():
    options = uc.ChromeOptions()
    options.page_load_strategy = "eager"
    for a in ("--headless", "--no-sandbox",
              "--disable-blink-features=AutomationControlled"):
        options.add_argument(a)
    return uc.Chrome(options=options, version_main=136)
Пара флагов здесь важна. page_load_strategy = "eager" говорит драйверу: не жди полной загрузки картинок и виджетов, нам хватит DOM. А --disable-blink-features=AutomationControlled убирает главный признак автоматизации, по которому антибот-системы отличают бота от человека.
Мелочь? Возможно. Но именно на таких мелочах и рушатся наивные парсеры.
Как вытащить числа со страницы
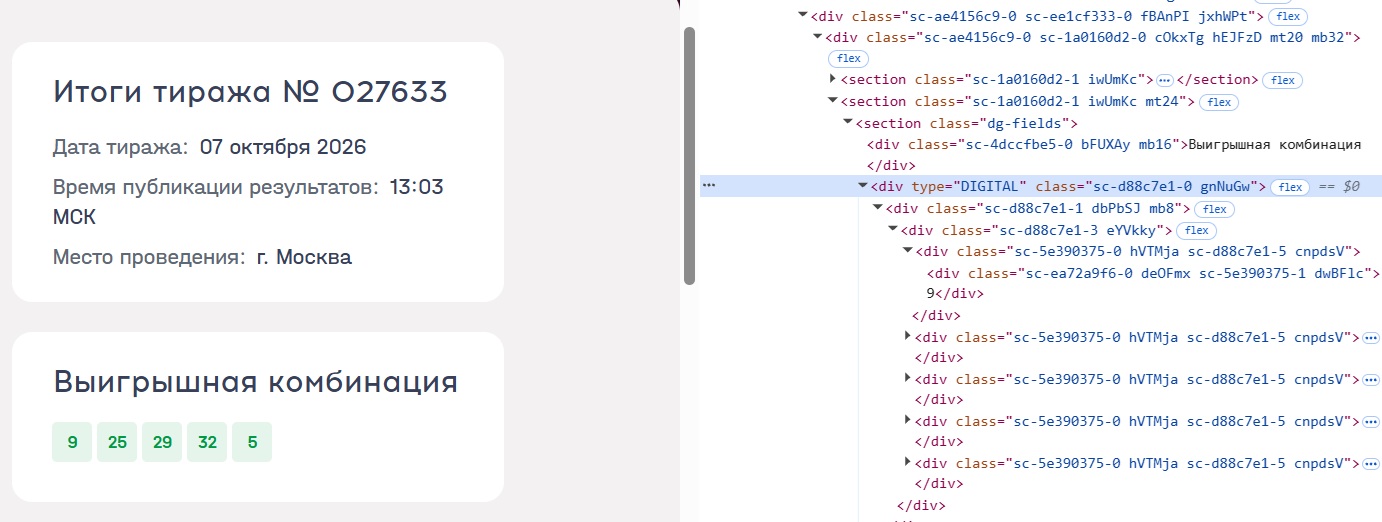
Структура страницы тиража: контейнер div[type='DIGITAL'], внутри — набор div-ов, каждый с одним числом. Страница рендерится JavaScript'ом, поэтому сразу после get() чисел ещё нет — их нужно дождаться.
def parse_digital_numbers(driver, timeout=30):
    digital = WebDriverWait(driver, timeout).until(
        EC.presence_of_element_located((By.CSS_SELECTOR, "div[type='DIGITAL']"))
    )

    def appeared(d):
        return any(
            re.fullmatch(r"\d+", el.text.strip() or "")
            for el in digital.find_elements(By.TAG_NAME, "div")
        )

    WebDriverWait(driver, timeout).until(appeared)

    numbers, seen = [], set()
    for el in digital.find_elements(By.TAG_NAME, "div"):
        txt = el.text.strip()
        if re.fullmatch(r"\d+", txt) and int(txt) not in seen:
            seen.add(int(txt))
            numbers.append(int(txt))
    return numbers
Здесь два ключевых момента. Первый — ждём не просто появления контейнера, а появления хотя бы одного числа внутри него. Иначе легко поймать пустую заготовку. Второй — дедупликация: в вёрстке числа могут дублироваться (например, мобильная и десктопная версии блока), и без фильтра мы бы сохранили каждое дважды.
Основной цикл
Идём от старшего номера тиража вниз. На каждой итерации — переход на страницу, проверка, что мы не улетели на редирект, парсинг чисел, запись в БД, пауза.
Тут есть один тонкий момент, который я подсмотрел за годы работы с парсерами. Ошибки бывают разные, и смешивать их нельзя:
— Редирект на главную или страница без чисел — это семантические признаки: тиража, скорее всего, не существует. Пишем в skipped_draws и больше не трогаем.
— Таймаут парсинга — это временный сбой (сайт подвис, элементы не успели отрисоваться). Такое нельзя помечать навсегда, иначе мы потеряем реальный тираж. Просто пропускаем итерацию — при следующем запуске он снова попадёт в очередь.
Вот этот момент с разделением ошибок — один из тех, на которых новички спотыкаются постоянно: помечают всё подряд как «пропущено» и потом удивляются, почему в базе дырки.
Что в итоге
Запустив скрипт несколько раз батчами, мы постепенно накопим всю историю лотереи. В моём случае это без малого 27 тысяч тиражей — солидный датасет, на котором уже можно строить серьёзный анализ.
Попутно мы сделали всё, чтобы не быть похожими на бота: правильный драйвер, случайные паузы, неспешный темп обхода.
Данные собраны. Что дальше?
Дальше — самое интересное. В следующих частях мы займёмся анализом: посчитаем частоты выпадения чисел, поищем закономерности, построим первую стратегию ставки. И проверим её на исторических данных — как настоящие аналитики, а не как игроки, которые «чувствуют, что сегодня повезёт».
Собирать данные — это только половина дела. Самое интересное начинается, когда мы начнём искать в них смысл.
—
Нужен такой парсер под вашу лотерею? Хотите разобрать свою стратегию или заказать разработку? Пишите — обсудим задачу и найдём решение. Контакты — в профиле блога. Следующие части цикла выйдут совсем скоро, не пропустите.
Автор этого материала - я - Пахолков Юрий. Я оказываю услуги по написанию программ на языках Java, C++, C# (а также консультирую по ним) и созданию сайтов. Работаю с сайтами на CMS OpenCart, WordPress, ModX и самописными. Кроме этого, работаю напрямую с JavaScript, PHP, CSS, HTML - то есть могу доработать ваш сайт или помочь с веб-программированием. Пишите сюда.

 Программы на заказ
 Отзывы
 Контакты